
AI 前沿 · 每日整理
REINFORCE Zero:异步强化学习零失配,吞吐提升 2.4 倍
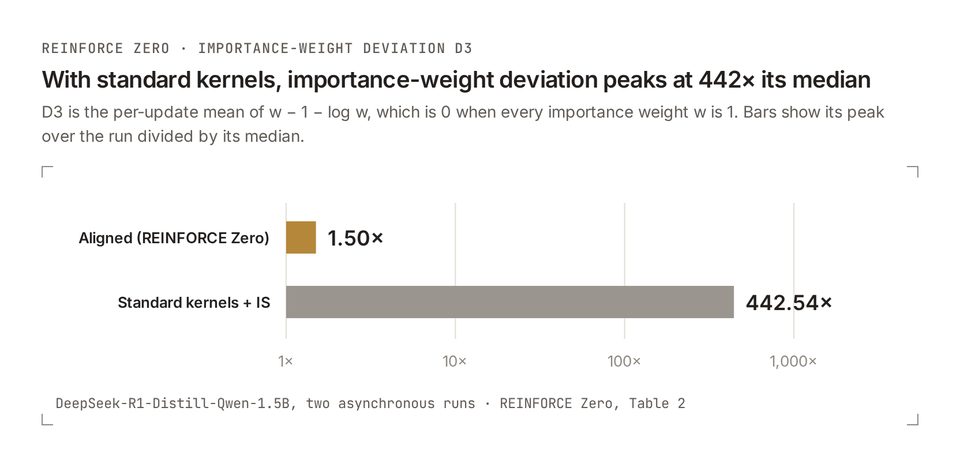
英伟达与 Inferact 提出 REINFORCE Zero,解决异步强化学习里“训练用的权重比推理用的旧”这个老问题:把推理核与训练核对齐到逐比特一致,再用无截断重要性采样修正滞后。结果吞吐提升 2.4 倍,2 万步稳定训练,滞后 64 步仍能学。DeepSeek-V4.1 与 Kimi K3.1 发布当天就获得了零失配支持。
原文摘录
Asynchronous RL is faster, but it trains on samples generated by older weights.(大意:异步强化学习更快,但它训练用的样本来自旧权重生成的数据。)
值得肯定
方法与效果都讲清了机制(核对齐加无截断采样),不是只给数字;DeepSeek-V4.1 与 Kimi K3.1 发布当天就支持,落地不是纸面
需要注意
对齐到逐比特一致的工程代价不低,小团队未必照搬得起;无截断采样在更大规模、更长训练里是否依然稳定,还没验证