
AI 前沿 · 每日整理
Buoyant 开源推理控制平面 Kinference:首 token 延迟从 6.88 秒降到 0.31 秒
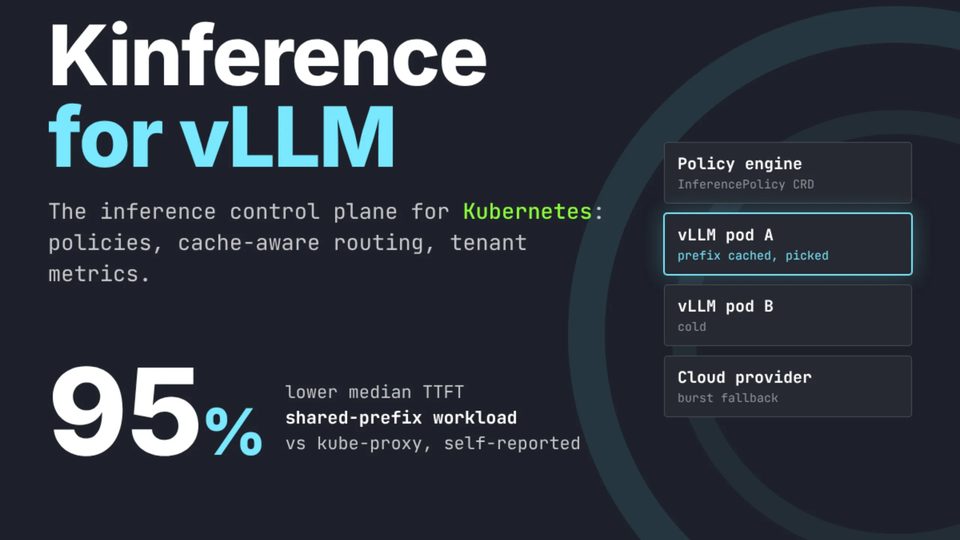
做过 Linkerd 的 Buoyant 公司开源了 Kinference,一个跑在 Kubernetes 上的大模型推理控制平面,专门管 vLLM 组成的机群:请求进来先由它决定发给哪台机器。它的核心本事是“KV 缓存感知路由”——大模型算过的前缀内容会以 KV 缓存的形式留在显存里,下次遇到相同前缀的请求直接复用,不用重算。按 Buoyant 自己公布的测试数据,在前缀大量重复的工作负载下,首个 token 的返回时间中位数从 6.88 秒降到 0.31 秒,降了约 95%,单位时间达标请求数是原来的约 7.4 倍;但没有共享前缀的普通请求几乎没提升。项目用 Apache 2.0 协议开源,当前版本是 v0.1.0-alpha.7,还是早期测试版。
原文摘录
Kinference is a policy-driven control plane that turns Kubernetes plus vLLM into a multi-tenant inference platform. Buoyant’s FAQ puts it simply: vLLM is the data plane and Kinference is the control plane.(大意:Kinference 是一个策略驱动的控制面,把 Kubernetes 加 vLLM 变成多租户推理平台。用 Buoyant FAQ 的话说:vLLM 是数据面,Kinference 是控制面。)
值得肯定
定位讲得很清楚:vLLM 是干活的数据面,Kinference 是发号施令的控制面,补的是“请求该发给哪台、不同部门怎么分账、敏感数据不许出内网”这层调度;配置通过 5 种 Kubernetes 自定义资源写成文件、可以进代码仓库做版本管理,还能离线校验
需要注意
95% 这个数字只能说明“比瞎分强很多”,不能说明“比同行强”:测试基线只是 Kubernetes 默认的随机分发,连另一款同类缓存感知路由工具 llm-d、NVIDIA Dynamo 都没拿来对比;目前只是 alpha 版,限流、分类器等功能还没做,生产环境直接上还太早